Nvidia verkürzt einen aufwendigen Vergleich von Quantenfehlerkorrektur-Verfahren von rechnerisch rund zwölf Wochen auf 45 Minuten. Möglich macht das der Algorithmus TCBP-JOBS, der auf einer klassischen GB200-Grafikkarte läuft und simulierte Fehlerdaten auswertet. Der Benchmark umfasst 24,2 Millionen Dekodierungen aus 28 Fehlerkorrektur-Schaltungen. Er ist ein Forschungsmaßstab, kein Beleg dafür, dass ein Quantencomputer diese Aufgabe in weniger als einer Stunde erledigt hat.
Die Vorstellung erfolgte am 16. November 2026 im Umfeld der Supercomputing-Konferenz SC26. Nvidia stellt TCBP-JOBS über die Bibliothek CUDA-Q QEC 0.9.0 bereit und beschreibt den Ansatz als Beschleunigung für die Entwicklung fehlertoleranter Quantencomputer. Die zugrunde liegende Arbeit stammt von Ben Howe, Satvik Maurya und weiteren Forschern von Nvidia. Sie ist als Preprint auf arXiv veröffentlicht und wurde bislang nicht in einem begutachteten Fachjournal publiziert.
Der Unterschied zwischen klassischer und quantenmechanischer Rechenarbeit ist für die Meldung zentral. Die Grafikkarte simuliert nicht den vollständigen Quantencomputer und übernimmt auch keine Quantenoperation. Sie berechnet vielmehr, welche Fehler in einem Modell eines Quantenprozessors wahrscheinlich aufgetreten sind. Solche Berechnungen helfen Forschern, die Schutzverfahren zu entwickeln, ohne für jeden Vergleich ein reales Quantenchip-Experiment durchführen zu müssen.
Qubits sind empfindliche Informationseinheiten. Anders als klassische Bits können sie quantenmechanische Überlagerungen und Verschränkungen nutzen, reagieren aber zugleich auf Störungen durch ihre Umgebung, ungenaue Operationen und fehlerhafte Messungen. Schon einzelne Fehler können das Ergebnis einer längeren Rechnung verfälschen. Für praktische Anwendungen müssen Quantenprozessoren deshalb Fehler erkennen und korrigieren, während die Berechnung weiterläuft.
Ein verbreiteter Weg besteht darin, mehrere physikalische Qubits zu einem logischen Qubit zusammenzufassen. Die zusätzlichen Qubits tragen redundante Information, mit der sich Störungen erkennen lassen. Wiederholte Messungen liefern dabei sogenannte Syndrome: Muster, die Hinweise auf Fehler enthalten, ohne den geschützten logischen Zustand direkt auszulesen. Ein Decoder wertet diese Messdaten aus und schlägt eine passende Korrektur vor. Er arbeitet klassisch, auch wenn die Daten aus einem Quantenprozessor stammen.
Die Wahl des Fehlerkorrektur-Codes beeinflusst, wie viele physikalische Qubits für eine bestimmte Zahl logischer Qubits nötig sind und wie gut Fehler unterdrückt werden. Surface Codes sind intensiv untersucht und vergleichsweise gut an lokale Verbindungen zwischen benachbarten Qubits angepasst. Color Codes und sogenannte Bivariate-Bicycle-Codes verfolgen andere Strukturen und können unter bestimmten Bedingungen mehr logische Qubits mit geringerem Hardware-Aufwand codieren. Ihre praktische Bewertung hängt jedoch stark davon ab, wie zuverlässig ein Decoder die Messdaten interpretiert.
Der neue Ansatz kombiniert zwei Verfahren. TCBP steht für Trajectory-Calibrated Belief Propagation. Es nutzt nicht nur den letzten Zwischenstand eines iterativen Rechenverfahrens, sondern betrachtet den Verlauf der geschätzten Fehlerwahrscheinlichkeiten über mehrere Rechenschritte. Daraus wird ein kalibriertes Modell abgeleitet, das die Wahrscheinlichkeit einzelner Fehlermechanismen genauer einordnet. Laut den Autoren lässt sich dieses Modell für eine Codefamilie anhand simulierter Daten anpassen; dafür sind keine Messdaten eines realen Quantenprozessors erforderlich.
Der zweite Teil heißt JOBS, kurz für Jittered OSD Beam Search. Das Verfahren verändert die Reihenfolge, in der mögliche Fehler untersucht werden, und startet mehrere Suchläufe parallel. Eine begrenzte Strahlensuche – im Englischen Beam Search – verfeinert anschließend die gefundenen Korrekturen. Die GPU kann diese Suchpfade gleichzeitig bearbeiten. Dadurch nutzt der Algorithmus die vielen parallel arbeitenden Recheneinheiten der Grafikkarte, statt eine lange Folge einzelner Suchschritte auf einem CPU-Kern abzuarbeiten.
Die Kombination soll Geschwindigkeit und Genauigkeit verbinden. Ein sehr einfacher Decoder kann zwar schnell sein, aber bei schwierigen Fehlerbildern zu oft eine falsche Korrektur wählen. Ein aufwendiger Suchdecoder kann genauer arbeiten, benötigt dafür jedoch viel Rechenzeit. TCBP-JOBS versucht, die Suche mit besseren Wahrscheinlichkeitswerten gezielter zu lenken und viele Kandidaten gleichzeitig zu prüfen. Die Autoren vergleichen den Ansatz deshalb mit Tesseract, einem rechenintensiven Decoder aus dem Umfeld von Google Quantum AI.
Für den großen Lauf verwendete das Team 28 simulierte Schaltungen aus drei Codefamilien: zehn Surface-Code-Schaltungen, zehn Color-Code-Schaltungen und acht Bivariate-Bicycle-Schaltungen. Insgesamt wurden 24,2 Millionen sogenannte Shots ausgewertet. Ein Shot ist ein einzelner simulierter Durchlauf mit Messdaten, aus denen der Decoder die wahrscheinlich aufgetretenen Fehler ableitet. Die Simulation nutzte das SI1000-Rauschmodell und eine physikalische Fehlerrate von 0,2 Prozent.
TCBP-JOBS verarbeitete die Daten in Stapeln auf einer einzelnen Nvidia-GB200-GPU. Die Vergleichswerte für Tesseract stammen aus bereits veröffentlichten Ergebnissen des Tesseract-Projekts. Die Autoren haben diese CPU-Messungen für den Benchmark nicht erneut ausgeführt. Aus den dort dokumentierten Thread-Stunden errechneten sie eine Laufzeit für einen Server mit 64 CPU-Kernen, wobei die Rechenarbeit ideal auf diese Kerne verteilt wird. Genau diese Hochrechnung ergibt den Vergleichswert von 12,1 Wochen.
Auf der GB200 dauerte die gesamte Dekodierung laut Tabelle 13 des Papers 45 Minuten. Tesseract benötigte für dieselbe Menge an Benchmark-Daten 130.257 CPU-Thread-Stunden. Die Gegenüberstellung entspricht einem Faktor von rund 2.720. Der Unterschied fällt je nach Codefamilie unterschiedlich aus: Bei den Surface Codes beträgt der Faktor 62, bei den Color Codes 2.060 und bei den Bivariate-Bicycle-Codes 3.400. Die Schlagzeile bezieht sich somit auf einen konkreten Gesamtbenchmark und nicht auf jede einzelne Berechnung.
Auch die Genauigkeit wurde verglichen. Über den gesamten Benchmark liegt das geometrische Mittel des Verhältnisses der logischen Fehlerraten bei 1,05 zugunsten von TCBP-JOBS. Einzelne Codegrößen weichen davon ab: Bei einem Color Code fällt der Vergleich zugunsten von Tesseract aus, während TCBP-JOBS bei anderen Konfigurationen weniger logische Fehler verzeichnet. Die Ergebnisse sprechen daher für eine im Mittel ähnliche Genauigkeit in diesem Testfeld, nicht für eine ausnahmslos bessere Fehlerkorrektur.
Der Gesamtbenchmark misst, wie schnell eine große Menge simulierter Daten verarbeitet wird. Daneben untersuchten die Forscher die Zeit für einzelne Dekodierungen ohne Stapelverarbeitung. Bei einer Schaltung des Bivariate-Bicycle-Codes mit der Bezeichnung [[144,12,12]] benötigte Tesseract auf einem einzelnen Grace-CPU-Kern im Mittel 53,5 Sekunden. Die GB200-GPU kam für denselben Vergleich auf 4,09 Millisekunden. Daraus ergibt sich ein Geschwindigkeitsvorteil von rund 13.100.
Diese Einzelmessung ist nicht mit dem 45-Minuten-Benchmark gleichzusetzen. Sie beschreibt die Latenz eines einzelnen Durchlaufs, während der große Lauf Millionen Durchläufe in Batches bündelt und den Gesamtdurchsatz misst. Zudem vergleichen die Forscher eine CPU-Ausführung mit einer GPU, also keine zwei gleichartigen Prozessoren. Die Zahlen zeigen, wie stark parallele GPU-Suche bei dieser konkreten Aufgabe helfen kann; sie sind kein allgemeiner Leistungsfaktor für Quantencomputer oder beliebige Software.
Für die Forschung zählt nicht nur, ob ein einzelner Code funktioniert. Entwickler müssen viele Varianten von Fehlerkorrektur-Codes, Schaltungen und Decoder-Einstellungen untersuchen. Jeder zusätzliche Vergleich kann zeigen, ob ein Entwurf bei gleicher Fehlerrate weniger physikalische Qubits benötigt oder mehr logische Information zuverlässig schützt. Wenn eine solche Untersuchung statt Wochen nur einen Teil einer Stunde beansprucht, können Teams mehr Varianten prüfen und ungünstige Entwürfe früher aussortieren.
Das kann langfristig den Weg zu Quantencomputern verkürzen, die längere Berechnungen zuverlässig ausführen. Besonders interessant sind Codes, die mehrere logische Qubits mit vergleichsweise wenig physikalischer Hardware speichern. Sie stellen jedoch andere Anforderungen an die Verbindungen und Messungen im Prozessor. Schnellere klassische Decoder erlauben es, diese Zielkonflikte systematischer zu untersuchen, bevor eine Architektur in Hardware umgesetzt wird.
Die Rolle klassischer Supercomputer und Grafikkarten bei dieser Entwicklung ist bereits größer als die reine Auswertung von Fehlern. So wurde auch ein fehlertoleranter Quantenprozessor mit 104 Qubits auf dem JUPITER-Supercomputer simuliert, wobei Tausende Grafikprozessoren die Modellrechnung ermöglichten. Eine solche Simulation prüft das Verhalten eines geplanten Systems unter angenommenen Bedingungen. TCBP-JOBS setzt an einer anderen Stelle an: Es beschleunigt die Suche nach passenden Fehlerkorrekturen innerhalb solcher Forschungsabläufe. Beide Ansätze zeigen, wie eng klassische Hochleistungsrechner und die Entwicklung von Quantenhardware zusammenarbeiten. Einen Kontrast dazu liefert ein Experiment, bei dem ein Quantencomputer eine Aufgabe tatsächlich selbst ausführte.
Ein weiterer Unterschied liegt zum tatsächlichen Einsatz an einem Quantenprozessor. Für den laufenden Betrieb muss ein Decoder neue Messdaten rechtzeitig verarbeiten, damit der Quantencomputer ohne Verzögerung fortfahren kann. Das Paper berichtet auch über Millisekunden-Latenzen in bestimmten simulierten Speicherschaltungen und logischen Operationen. Die Autoren sehen darin Potenzial für Systeme mit längeren logischen Taktzyklen, etwa bei neutralen Atomen oder Ionenfallen. Für sehr schnelle supraleitende Prozessoren mit wesentlich kürzeren Zyklen ist diese Zeitspanne eine andere Herausforderung.
Der wichtigste Vorbehalt betrifft die Datenbasis. Die 24,2 Millionen Durchläufe stammen aus Simulationen und nicht aus einem Experiment mit einem laufenden Quantencomputer. Das SI1000-Modell bildet bestimmte Fehlerannahmen ab, kann aber nicht jede Störung eines realen Geräts vollständig erfassen. Auch die Vergleichszeit von 12,1 Wochen ist eine Hochrechnung auf 64 CPU-Kerne und setzt eine ideale Verteilung der dokumentierten Rechenarbeit voraus. Der Benchmark belegt damit einen großen Fortschritt bei einer klar umrissenen Forschungsaufgabe.
Hinzu kommt die Herkunft der Arbeit. Das Paper wurde von Forschern des Unternehmens Nvidia verfasst und als Preprint auf arXiv eingereicht. Eine unabhängige Replikation des Gesamtbenchmarks liegt bislang nicht vor. Auch die CPU-Vergleichsdaten wurden aus dem Tesseract-Projekt übernommen und nicht im selben Versuch auf identischer Hardware neu gemessen. Die CUDA-Q-Dokumentation erläutert diese Vergleichsbedingungen ausdrücklich und weist darauf hin, dass die verwendete Tesseract-Konfiguration nicht sämtliche verfügbaren Varianten repräsentiert.
Für den Echtzeitbetrieb ist außerdem die reine Dekodierzeit nicht die gesamte Verzögerung. Messdaten müssen ausgelesen, übertragen und in die Steuerung des Quantenprozessors eingebunden werden. Auch die Reaktion auf eine berechnete Korrektur gehört zur Gesamtlatenz. Wie gut der Ansatz in einer vollständigen Hardwaresteuerung funktioniert, muss deshalb in konkreten Systemen geprüft werden. Die Autoren benennen weitere Untersuchungen mit anderen Codefamilien und Architekturen als künftige Arbeit.
Parallel zur Algorithmusvorstellung kündigte Nvidia eine Zusammenarbeit mit IBM und dem Fermi National Accelerator Laboratory an. Geplant ist eine Plattform, auf der klassische Hochleistungsrechner und Quantenprozessoren gemeinsam entwickelt und getestet werden können. Die Beteiligten wollen damit Fehlerkorrektur-Codes, Decoder und Anwendungen für modulare Quantencomputer untersuchen. Einen konkreten Starttermin für die Plattform nannte Nvidia nicht.
Der praktische Wert des neuen Verfahrens liegt vorerst in der schnelleren Entwicklungsarbeit: Mehr Codes und Einstellungen lassen sich innerhalb derselben Forschungszeit vergleichen. Ob daraus tatsächlich kleinere, fehlertolerante Quantencomputer entstehen, hängt weiterhin von der Qualität der Codes, der Hardware und der Steuerung ab. Die 45 Minuten markieren einen deutlichen Fortschritt bei der klassischen Berechnung simulierter Fehlerdaten – nicht den Abschluss des Weges zum universell einsetzbaren Quantencomputer.
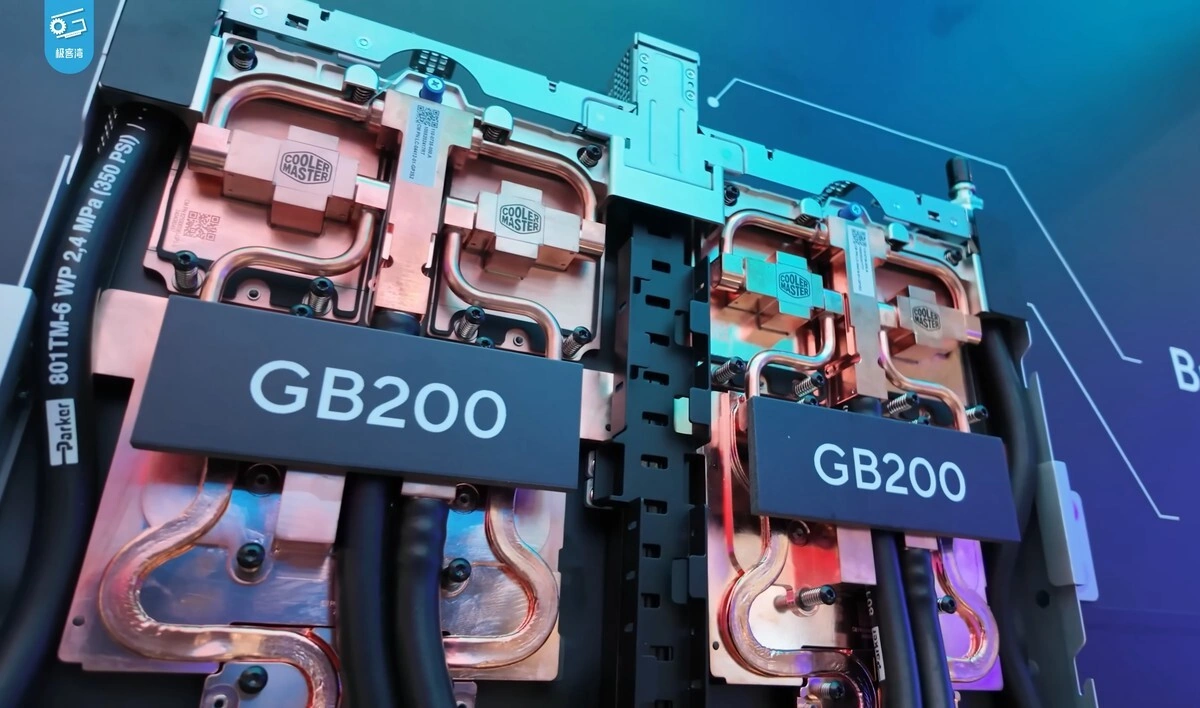
Titelbild: Nvidia-GB200-Module von 极客湾Geekerwan, Wikimedia Commons, Lizenz CC BY 3.0, Hintergrund erweitert.
NVIDIA, „NVIDIA Announces Collaboration With IBM and Fermi National Accelerator Laboratory to Launch Quantum-Classical Codesign Platform, Plus Error-Correction Breakthrough to Advance Practical Quantum Computing“
Ben Howe et al., „TCBP-JOBS: GPU-Accelerated Quantum Error Correction Decoding and Noise Learning with Near-Optimal Accuracy“; arXiv:2611.21321
NVIDIA CUDA-Q QEC, „Accuracy and Latency of TCBP-JOBS“
Mit KI-Unterstützung erstellt
Wählen Sie Forschung und Wissen bei Google als bevorzugte Quelle oder folgen Sie uns per RSS-Feed.